
01 Meta发布Muse Glimmer,把Agent带到本地
当地时间 8 月 10 日,Mark Zuckerberg发布《The Future is for Everyone》,把Meta的AI路线概括为个人赋能、发明能力与权力平衡。
文章设想了 24 小时在线的个人Agent、完全私密模式以及免费或低价版本。Meta同日发布Muse Glimmer:一款 30B参数、Apache 2.0 许可的开放权重模型,定位包括本地Agent、函数调用、本地编程和模型评审。
我先查的是硬件门槛,因为它比“能在个人电脑上运行”这句话更值得看。Meta的资料称,全精度运行需要 55GB以上内存;特定K-Quant版本约 17GB,连同KV cache、视觉编码器和辅助模型,目标是进入 24GB或 32GB内存环境。官方测试平台包括MacBook M4 Max、M5 Max与RTX 5090。
这里最容易踩坑的是把“开放权重”“17GB”和“即将支持”都写得过满。有几处很容易写过头:
- Muse Glimmer是开放权重,不等于训练数据和完整训练流程全部开放;
- 17GB对应特定量化版本,不代表普通办公电脑都能流畅运行;
- 性能数字来自Meta自评,尚需更多独立测试;
- llama.cpp、MLX、ExecuTorch、Ollama和LM Studio等优化集成,官方表述是随后陆续提供,不能写成已经全部上线。
我为什么关注
本地Agent能带来更强的隐私、离线能力、低延迟和更低的边际调用成本。但它也把新的责任交给设备端:工具权限怎样隔离、模型怎样更新、长期任务如何审计、越界操作能否被停止。
Meta真正推出的并不只是又一个 30B模型,而是一条让Agent离开云端、进入个人环境的路线。
02 Shape Your Feed:用户开始主动“指挥算法”
再看信息流。Meta研究团队 8 月 6 日提交的论文Shape Your Feed,展示了个人Agent在产品界面的另一个落点。
传统推荐系统主要从点击、停留时长等行为猜测偏好。Shape Your Feed则允许用户通过文字、语音和界面控件直接表达意图,例如“少一些标题党”“最近多看烹饪内容”。
系统分成三层:
- Perception Flow解析用户意图;
- Serving Flow根据持续更新的Semantic Profile实时重排和过滤内容;
- Self-Evolution Flow使用在线反馈、DPO与多个judge持续校准策略。
论文称,在美国、加拿大成年用户的数月线上A/B测试中,上下文反馈选项占相关交互的 76.02%;Post Dismiss Rate下降 1.70%,Post Dislike Rate下降 2.74%,新兴趣内容消费提升 0.16%。关键路径延迟增加 0.043%。
我对照这些数字时,最先确认的是实验范围:它只覆盖两国成年用户的随机子集;这是Meta的工业论文,不代表完整功能已经向所有Facebook或Instagram用户开放;沉默用户仍会主要依赖传统推荐逻辑。
另一个容易被标题带偏的数字是 98.85%。它指alignment scoring模块在LLM-judge标注集上的准确率,不是“推荐准确率”。独立人工标注的 1029 个样本上,论文报告准确率为 95.8%、F1 为 75.1%。
我为什么关注
信息流过去是一台不断猜测你的机器。Shape Your Feed想把它变成可以对话和修正的系统:用户不必只靠反复点击训练算法,而能明确告诉它当前想看什么、又不想看什么。
如果这套交互真的进入大规模产品,推荐系统的核心指标也需要变化。除了点击率和停留时长,平台还要回答:用户表达的偏好是否被正确理解,改变是否可见,长期画像能否被检查和撤销。
我的判断
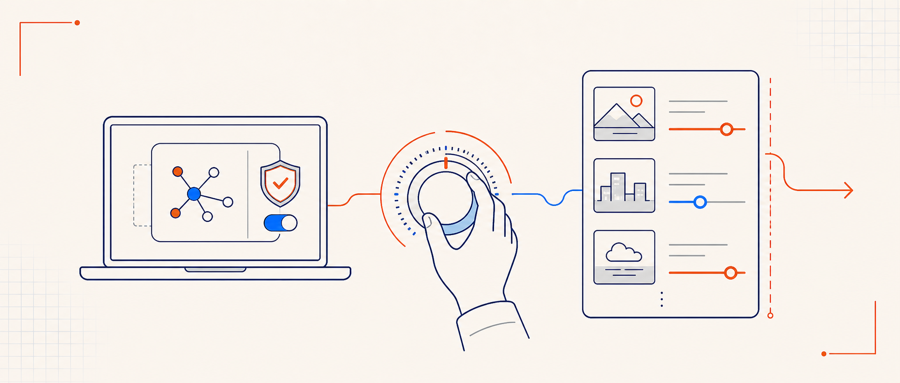
个人Agent的真正门槛,不只是模型能不能在一台电脑里跑起来。
它至少需要三层控制:
- 运行控制:数据留在哪里,哪些任务可以离线完成;
- 权限控制:Agent可以访问哪些文件、应用和网络;
- 意图控制:用户能否看见、修改和撤销系统对自己的判断。
Muse Glimmer解决的是第一层的一部分,Shape Your Feed则触碰了第三层。第二层——权限与副作用能否被审计和拦截——仍会决定这些Agent能不能真正进入日常工作。
如果是我来评估一个“个人Agent”,不会先看模型榜单,而会先问四个问题:它在哪里运行,能访问什么,为什么这样做,以及我能不能让它停下来。这四个问题答不清,再漂亮的能力数字也不会成为我的首选。