
这几天,我一直在看三件不太一样的更新。
OpenAI更新了Agents SDK;Anthropic发布了一份新的风险报告;Z.ai上线GLM-5.3,却没有同时开放模型权重。
一个是开发工具,一个是公司内部的研发状态,一个是开放模型的发布安排。它们表面上离得很远,放在一起却刚好回答同一个问题:AI跑得越来越快,刹车到底应该装在哪里?
这期不是产品实测。我对照了三家的发布记录和风险报告,也查了媒体的交叉报道。看完以后,我更愿意把这三条新闻理解成一次“刹车位置”的集体调整。
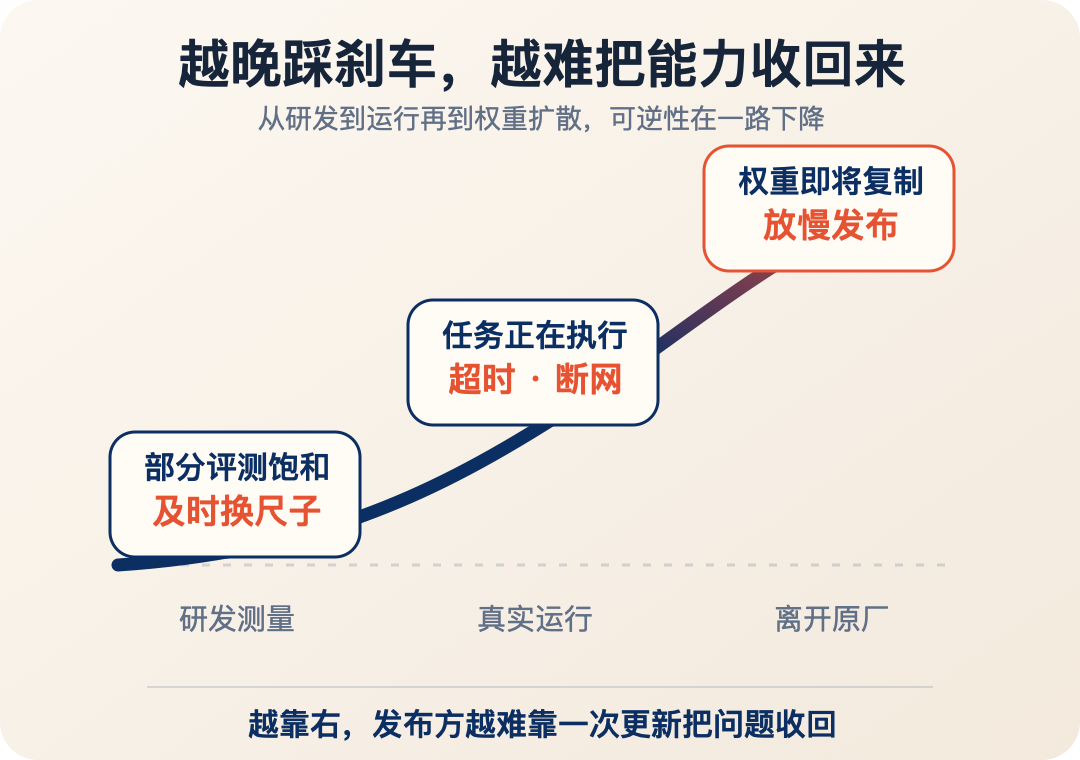
我把它们画在同一条线上,能更清楚地看到三处刹车分别落在哪里。
OpenAI先把刹车装进Agent运行时
OpenAI Agents SDK for Python在8月15日发布0.21.0,8月17日今晨又发布0.21.1。
这两次更新没有新模型,改的都是Agent真正跑起来以后会遇到的问题。
比如,模型调用可以设置超时;Docker沙箱可以直接关闭网络;开发者可以不用真实请求模型,就重复测试Agent、沙箱和语音工作流。
它还修了一个很细的审批问题:如果系统已经针对某个具体调用做了决定,这个决定应该优先于默认审批结果,而且只影响那一次匹配的调用。
这些功能看起来都不如模型榜单热闹,却更接近Agent进入真实工作的门槛。
模型卡住了,能不能按时停下;任务失败了,资源能不能收干净;涉及外部网络和工具操作时,权限能不能被真正限制。任何一个没处理好,模型越能干,副作用反而越大。
我最近一直在折腾长任务、多Agent和工具调用。最常见的麻烦不是模型不会做,而是失败以后留下脏状态,或者一个本应很具体的批准,被系统理解得太宽。
所以我看Agent框架更新,已经不太关心它又接了几个模型。我会先找三样东西:超时在哪里,网络能不能断,失败能不能稳定复现。
这三样都找不到,“支持生产环境”大概率还只是句口号。
Anthropic说研发变快了,但尺子开始不够用了
第二条来自Anthropic在8月14日发布的风险报告。先交代一个时间边界:这份报告覆盖到7月15日,写的是截至当时的内部状态。
报告提到一个尚未发布的内部模型Model 2。Anthropic称,它在许多内部任务上比Mythos 5有明显进步;截至报告覆盖日,公司没有发布它的计划,也没有宣布暂停Model 2或整体研发。
比“又有一个更强模型”更值得看的,是Anthropic怎样使用这些模型。
报告称,Mythos 5和Model 2已经广泛参与内部研究和工程。Claude现在写下了其生产代码库中合入代码的大部分,内部AI研发也明显提速,但还没有达到两倍,而且这个速度很难准确测量。
偏偏在这个时候,一些最具体的任务评测已经“饱和”,开始看不出模型还在怎样进步。
这不是“AI已经会自己研发下一代AI”。更准确的说法是,AI正在越来越深地参与AI公司的研发,而过去一些具体任务型评测,已经开始量不出新的变化了。
这份报告里,我最在意的不是Model 2这个名字,而是“评测饱和”四个字。
如果越来越多生产代码由AI写下,评测和放行又依赖相似的模型,那么研发当然会变快,但同一类盲区也可能一起被放大。
这时真正缺的不是再跑一次旧榜单,而是一把新的、尽量独立的尺子:谁来复核关键变更,谁能推翻模型的判断,什么信号出现时必须暂停。
Z.ai先上线模型,两周后再放权重
8月14日,Z.ai上线GLM-5.3时,没有同步放出模型权重。
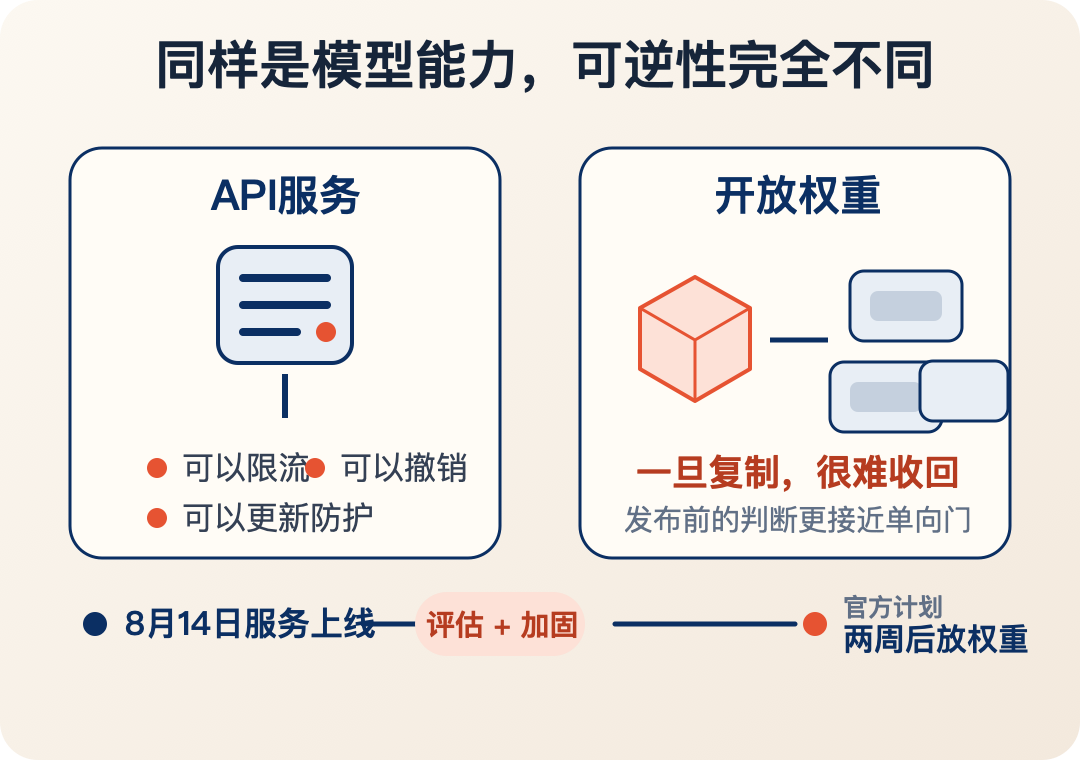
官方说法是,先继续做安全评估和加固,再于模型上线两周后发布权重。也就是说,服务上线和权重开放被拆成了两步。
为什么要留这两周?Z.ai给出的理由是网络安全能力。
公司称,GLM-5.3在CyberGym上的得分达到84.5%;经过专家复核、筛选和去重后,GLM系列识别出2436个漏洞。目前官方账本只公开了其中53项,其余仍在披露流程中。
这些数字都是Z.ai自己的口径,还要等更多第三方复测。但我觉得,“先不放权重”这个动作,比84.5这个分数更值得记下来。
API模型出了问题,还可以限流、撤销访问、更新服务端防护。权重一旦被下载和修改,发布方就很难再把它收回来。
过去看开放模型,我通常先看性能、许可证和部署成本。GLM-5.3让我多加了一个问题:在权重离开原厂之前,最危险的能力到底验证到哪一步?
两周当然不是安全证明。真正要看的,是这段时间最后换来了什么:更清楚的评估门槛、具体的加固动作,还是可以被第三方重复检查的证据。
如果两周后只有一个下载链接,那这次停顿的价值就很有限。
把这三条新闻放回一起,它们并不能证明AI已经更安全了。
但它们至少说明,行业开始意识到:刹车不能只写在原则里,也不能等出事以后再找。
Agent运行时需要能超时、断网和复现失败;AI参与研发以后,需要在部分具体评测失去区分度时及时换尺子;模型权重变得难以收回时,发布节奏本身也得成为安全机制的一部分。
真正有效的刹车,不能依赖某个人刚好记得踩它。它应该在失败路径里自动出现,而且踩下去以后,还能留下证据告诉我发生了什么。
所以下次再看到一个更强的模型,我大概不会先看它又赢了哪张榜单。
我会先找刹车:谁能让它停下来,停下以后能不能查清原因,以及还有哪些能力没有被急着放出去。