
水印还没看见,去水印先来了
看到Claude要给文字加水印,我第一反应不是技术,而是以前那些稿子。我经常让Claude顺几句病句、改几个标题,这以后会不会也被一股脑算成“AI写的”?
然后我去X上看了一圈。果然,水印还没看见,“解决方案”已经有人做出来了。
8月11日,一位开发者发帖说Claude会给它写的每句话加水印,紧接着就丢出了一个免费的Claude Watermark Remover。截至8月17日上午,原帖有26万多次浏览;开发者后来又说,这个站一天来了8500名用户。速度很X:Anthropic刚把门装上,旁边已经有人摆摊卖钥匙了。
站点叫claudewatermarkremover.app,看起来是个很快vibe出来的东西。功能也没多复杂:贴进一段Claude文本,点Remove watermark,它给你一份改写后的版本。整个站基本就是围着Anthropic刚宣布的“水印”,做了一个反方向的爆点。
背后的思路其实也不绕。既然这个水印不是藏几个字符,而是藏在一长段文字的选词偏向里,那最省事的破坏方法,就是让另一台模型把词重新选一遍。
问题也跟着来了:原文真有水印吗?改完又真的没了吗?
页面下方的FAQ倒是挺诚实。第二项专门问它会不会先检测水印,回答是Anthropic还没有公开检测API;目前做的是neutralize-by-rewrite,等官方检测器上线后,才可能补上“检测—改写—再检查”的循环。橙色Remove watermark按钮下面还有一行更小的Honest note,说的也是同一件事。
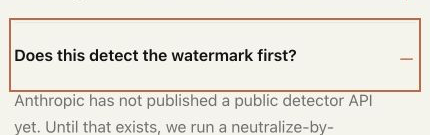
所以这个按钮现阶段更像Rewrite,不太像Remove。它可以给你换一套文字,但暂时不知道自己到底移除了什么。
这种站,我没敢直接扔稿子进去
网站说,输入会发到它的neutralize API,处理完就从请求生命周期里丢弃。这个说法我没法独立核验。为了检查一个还看不见的水印,先把未发布稿件交给一个刚上线的小站,我觉得有点绕。
同一位开发者后来开源了一个配套工具markscrub。它不是在线站点的完整源码,不过代码在GitHub,至少可以拉到本地慢慢看。这个我敢多折腾一点。
我让Agent固定到markscrub 0.2.0、提交bc2912c,安装、编译,再把22项测试跑完。然后拿这篇正在写的稿子做inspect:没有隐藏Unicode,也没有文件元数据命中;工具自己还提醒,没有厂商检测器,它看不出统计采样水印。
再跑clean,还是零发现、零操作。前后SHA-256完全一样,一个字节都没动。
我一度怀疑它是不是根本没干活,于是又拿项目自带的测试样本试了一遍。样本里故意塞了2个零宽字符和1个双向文本控制字符,markscrub都找到了,也确实删掉了。
这下大概明白了:工具不是没用,只是它擅长的是“字符里藏东西”。Claude这次玩的却是另一层,字符橡皮擦够不着。
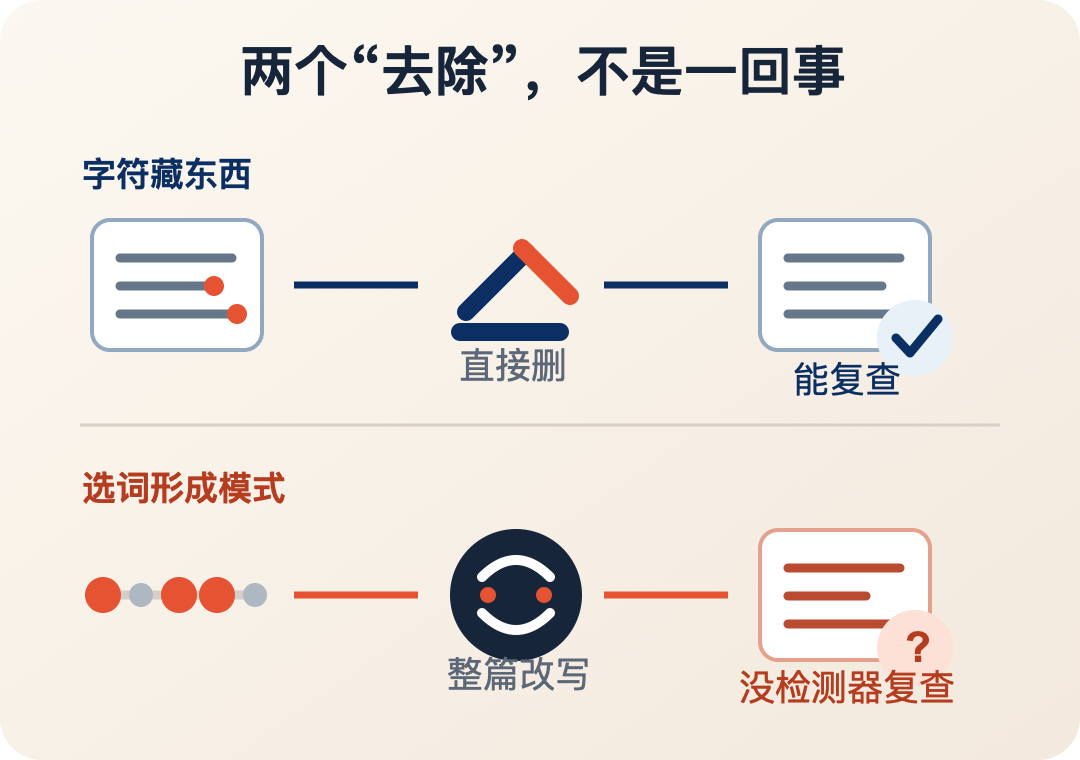
到了统计水印这一层,markscrub也只能走rewrite。它实际生成的Prompt不算客气:整篇重写,措辞和句式都要大改,基本每句话都动一遍;如果接模型,还建议用不同于原文来源的模型。
这已经不是从原稿里擦掉某样东西了,更像让另一台模型照着意思再写一份。
网站自己的示例,已经把代价写出来了
两段里没变的事实先省掉,真正有意思的是这些地方:
Before(只摘变化处)
… update for stakeholders … progress on the onboarding redesign … copy with brand voice …
After(对应改写)
… key parties involved … revamping the introductory process … conforms to the company's verbal identity …
事情倒是没变:还是入职流程、空状态、CTA、品牌文案和五位客户访谈。但把两段英文数一下,Before是46个词,After是74个词,长了61%。
我看完最直观的感觉,不是它把意思改错了,而是文字突然胖了一圈。原来像项目周报,改完更像一封公司邮件。事实和数字还在,语气、节奏,以及一句话愿不愿意说得干脆,已经换了一遍。
所以我更愿意把它叫全文改写器。至于水印有没有真的消失,在官方检测接口开放前,它还拿不出“改写前命中、改写后未命中”的闭环。
Anthropic说的水印,到底藏在哪儿
回到Anthropic自己的说明,第一句其实留了个很重要的边界:未来的Claude模型将生成带水印的文本。
这里的“未来”不能顺手抹掉。旧模型有几个月的过渡期,官方也没有给出每个模型、每个入口的完整生效表;检测API目前仍是“即将提供”。所以这篇文章做不了真正的水印实测,那个去水印站做不了,我也做不了。
Anthropic用的是Google DeepMind的SynthID-Text论文,有感兴趣的话可以自己去arxiv搜一下,公开的,让AI复现也很简单。粗暴理解,模型每次往下写,都可能有几个词能用。比如“清楚”“明白”“直观”,放进同一句话里都不算错。SynthID不额外塞一个字符,只在模型本来就要做的选择上,轻轻推一下概率。
一次推当然看不出来。可一篇长文里这样选上很多次,检测器就有机会从整体偏向里看出模式。具体往哪边推,会跟密钥和前文有关;换一段前文,候选词的分组也会跟着变,不是某几个词永远带水印。
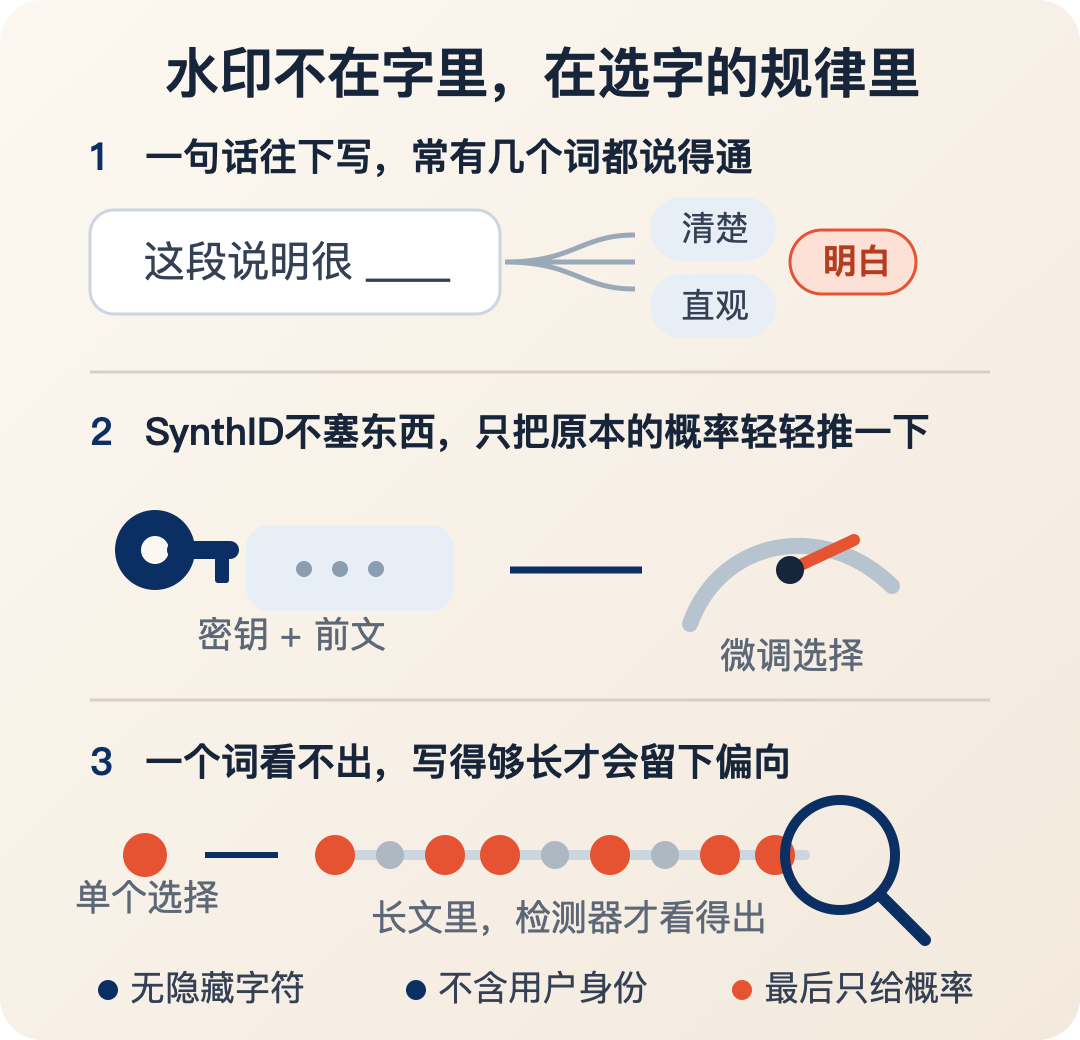
这也解释了为什么复制粘贴不会自动洗掉水印。你复制走的就是那串选词结果,统计模式当然跟着走,并没有一份隐藏附件黏在后面。
它能说明的事情其实不多:一段文字可能部分由Claude生成。它看不出是哪位用户、哪家公司、哪次对话,也证明不了文章里的观点、资料和判断是谁做的。
润色几句和全文代写,不能算成一回事
回到写稿,真正有用的问题不是“有没有用Claude”,而是Claude到底重新选了多少词,以及这些地方有多大的表达自由。这里谈的只是留下水印的机会,不是公开检测概率——检测器还没开放,谁现在给出一个漂亮百分比都太早。
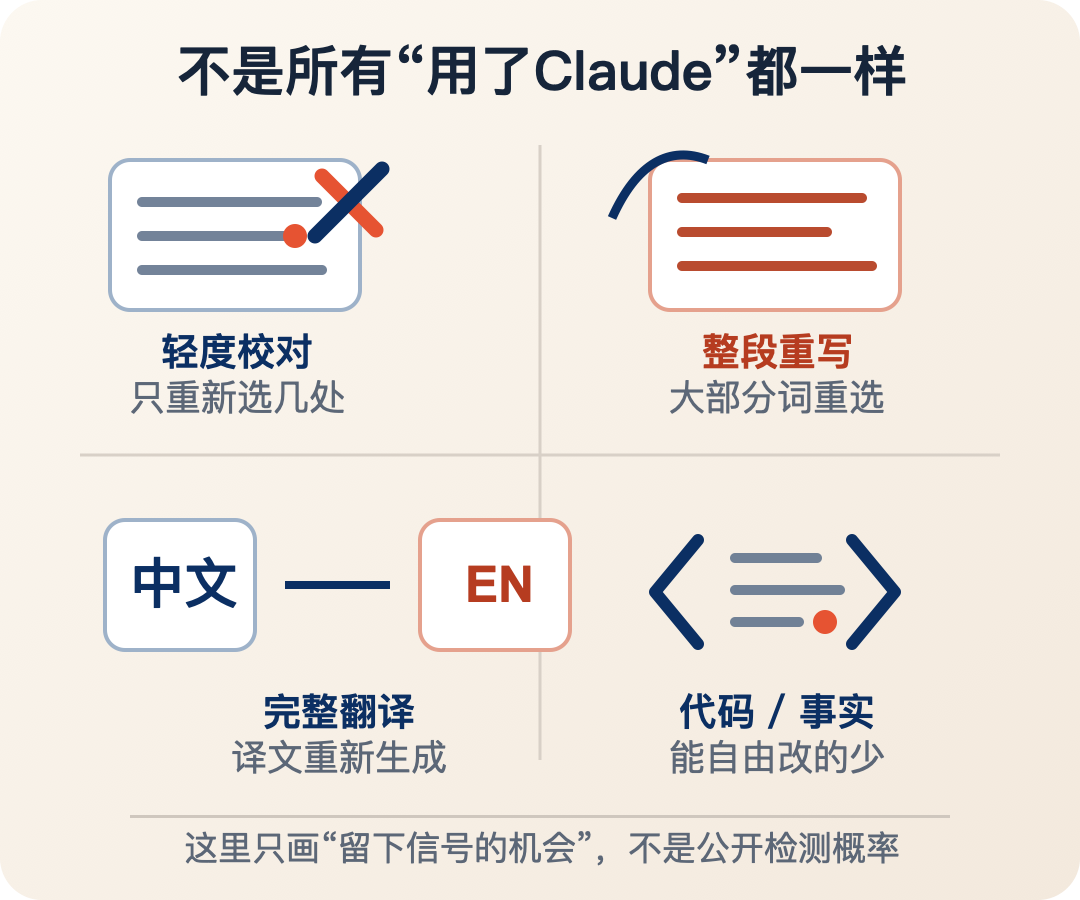
如果文章本来是我写的,只让Claude补标点、改几个病句,它真正重新选择的地方不多。Anthropic自己也承认,轻度校对留下的量可能不够检测。
整段重写就不同了。哪怕观点和材料都来自我,新句子里的大部分词还是Claude选的,统计信号自然更有机会累积。翻译也很容易被误解:中文原稿可以完全由人写,但整篇英文译文仍是模型重新生成的。那么很简单了,我们做中文文字产出的UGC,影响最大的部分肯定是在转译英文。
代码和事实性很强的文字又是另一个重大场景。一个函数该返回什么类型,答案没有多少腾挪空间;真正能变的往往是注释、变量名和解释文字。所以它们不是绝对没有水印,只是能做手脚的位置少。
这也是“每句话都有水印”最容易误导人的地方。句号后面并没有一枚印章。文本得够长,还得有足够多能换一种说法的位置,统计模式才有机会冒出来。
X上有位作者担心,自己做了选题、资料、观点和修改,只让AI帮忙润色,最后一张“检测到Claude”的截图就把整篇文章算成代写。这个担心,我觉得比一键去水印更实际。
检测器给的是概率,人却很喜欢把概率读成判决。有水印,未必分得清校对、翻译、重写还是代写;没水印,也排除不了模型参与。把它当来源线索还行,单独拿来判作者,多少有点用力过猛。
Anthropic还能拿来写内容产出吗?
折腾完这一圈,这个问题就进入了视野。AI模型产出内容是大势所趋,人之于模型上到底意义何在?我认为更主要还是把控方向和思路。再让另一台模型整篇重写,也许能冲淡统计模式,但顺手也会把我的思考框架和文章结构冲掉。
我更愿意留住那些笨一点的东西:最初的提纲、资料记录、自己写下的初稿和每一轮修改历史。真碰到作者归属争议,这些过程证据大概比一张检测器截图靠谱。
以后用Claude,我也会把它干了什么说清楚。校对就是校对,翻译就是模型生成的译文;如果一大段本来就是Claude写的,也没必要再用“只是润色”给自己找台阶。
真到严控UGC那时,才比较有资格讨论它到底能认出多少Claude,又会把多少正常写作卷进去。现在的话,那个大大的Remove按钮,我不急着点。